每次糾正 AI,該寫進 AGENTS.md 還是寫成檢查?Lauren Tan〈All Code Is Slop (Except Mine)〉觀後感
整理 Lauren Tan 在 AI Engineer Code Summit 的演講〈All Code Is Slop (Except Mine)〉:倒金字塔、183 個計時器的教訓、把每次糾正變成確定性檢查,以及 Grok Bot 團隊一個月合併一萬多個 PR、revert 比例反而降到 0.47% 的成績單。最後對照我現在在用的 Pyloxa,看「Agent 說做完了不算數」怎麼變成流程。
快速導覽 查看本文目錄
30 秒看懂這篇
- Lauren Tan 把讓人信任 agent 的投資排成倒金字塔:程式碼、靜態分析、驗證、文字規則、人工審查,越往下成本越高。
- 她的原則是每次糾正 agent,就改成 lint、測試或更好的 API,不在
AGENTS.md再加一行;Grok Bot 團隊的確定性檢查從 7 條累積到 167 條。 - 驗證是第三層:她們的 code review 已經縮成看驗證證據;我自己開發的 Pyloxa 也是讓命令與另一個 agent 驗證,agent 說做完了不算數。
- 看完後我想調整驗收:不只判斷單次任務成敗,而是讓驗收結果留到下一次再用,讓 AI 知道好的結果該保留、壞的要剔除。
安安~我是ChiYu~
〈 All Code Is Slop (Except Mine) 〉,這是 Lauren Tan 在 AI Engineer Code Summit 的講題,翻成中文大概是「所有程式碼都是垃圾,除了我的」。
她一上台先請大家舉手:有多少人看過別人寫的 code,心裡想著「這全是 slop」?她說她也有。接著她說,今天要說服大家,slop 可以變成黃金。
整場演講一直繞著一個很日常的問題:agent 做錯了,要怎麼糾正它?大多數人的直覺,是在 rules 或 AGENTS.md 再加一行。她的建議很直接:先想想能不能把這次糾正寫成確定性檢查,因為寫成程式碼可重現得多,也更值得信任。
這篇觀後感,就跟著她的投影片,把這個答案拆開來看。
Lauren Tan 是誰?SpaceXSI 團隊一個月合併一萬多個 PR
Lauren Tan(poteto)是 SpaceXSI 的 Principal Engineer,負責 Grok Bot,一個用 Electron 做的 agent 桌面 App。這場演講大約 17 分鐘。投影片上,她自己的 PR 數量從 3 月的 68 個,一路長到 10 月的 3,127 個。
整個 Grok Bot 團隊在 10 月合併了 10,926 個 PR。換算下來,一天大約三百多個。
聽到這種數字,很難不先懷疑:這樣不會變成一座垃圾工廠嗎?她在台上也先替觀眾問了這句。
她的論點是,軟體工程師現在的工作,就是在產能大增的同時,維持甚至提升程式碼品質。有人把這件事叫作軟體工廠,她則把它講成信任:不是盲目相信 agent,而是先投資 agent 的工作環境,讓你有理由相信它會做對。這段路,她走了大約六個月。
投影片上,她用兩個迴圈畫出這個差別。大部分人卡在左邊:agent 寫出 slop,人來檢查,找到問題再丟回去改。她想走到右邊:agent 寫出好的 code,也由 agent 自己檢查。
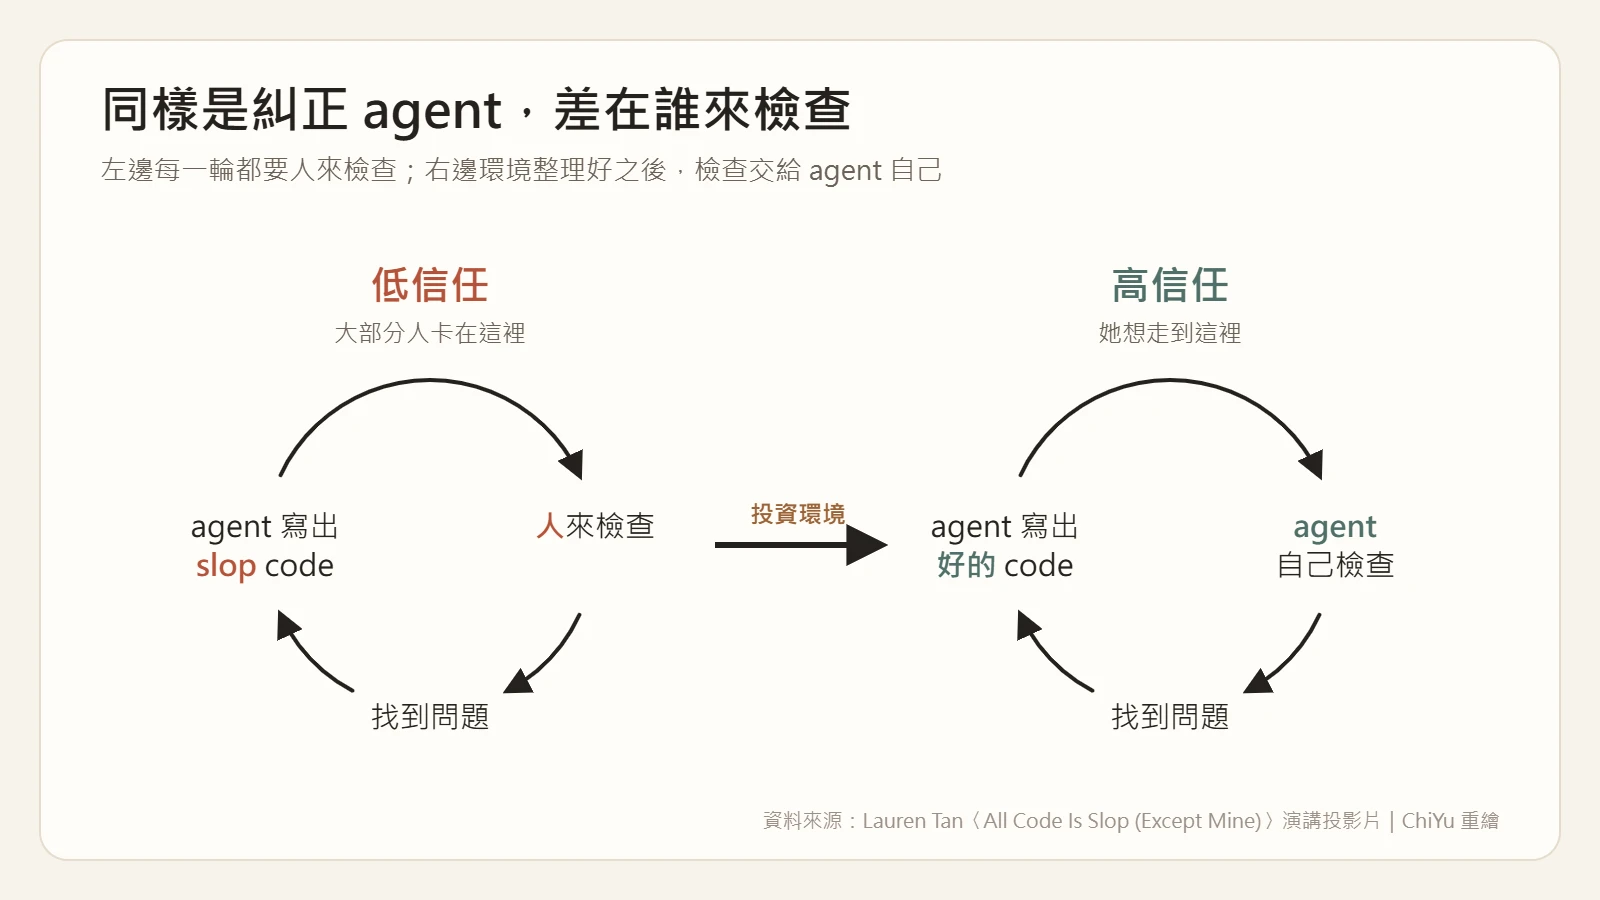
低信任與高信任的兩個迴圈,差別在檢查交給人還是交給 agent(依 Lauren Tan 投影片重繪)
倒金字塔:讓人信任 agent 的五層投資,越往下越貴
投影片上的這座金字塔,她叫它 the poteto pyramid。由上往下分成五層,旁邊有一個「cost」箭頭往下指:
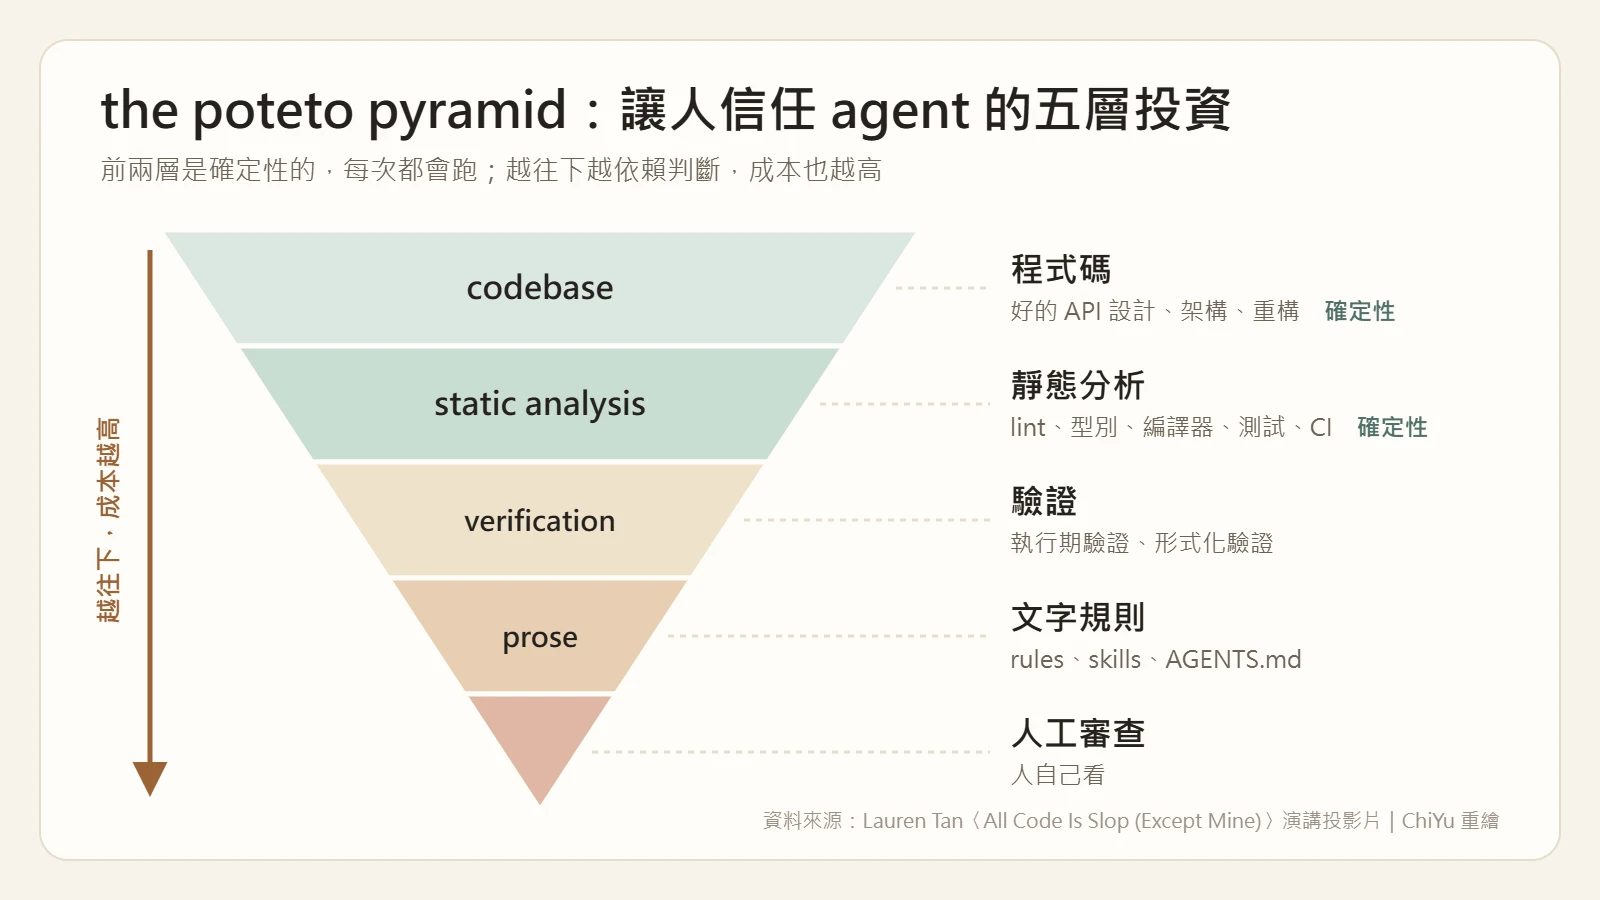
the poteto pyramid:由上往下是程式碼、靜態分析、驗證、文字規則、人工審查,越往下成本越高
每一層放什麼、她怎麼用:
| 層 | 包含什麼 | 她怎麼用 |
|---|---|---|
| codebase | 好的 API 設計、架構、重構 | 讓錯的寫法根本寫不出來 |
| static analysis | lint、型別、編譯器、測試、CI | 每次都會跑,寫錯就擋下 |
| verification | 執行期驗證、形式化驗證 | 抓 bug、檢查不變量,也確認 agent 有沒有懂你的意圖 |
| prose | rules、skills、AGENTS.md | 留給需要判斷的事 |
| human review | 人自己看 | 最尖、最貴的那一點 |
前兩層是確定性的。用程式碼本身和靜態分析限制 agent 能做什麼,它預設就會走在對的路上。
為什麼程式碼排第一?因為 agent 照著輸入產生輸出,而程式碼庫剛好是它最大的輸入。她用花園來比喻:2024 年她每天上班要審同事的 3 個 PR,現在大概是 300 個,code 湧進來的速度快到像一條連續的水流。程式碼庫裡的 workaround、反模式、廢棄的寫法,都會被下一個 agent 當成既有慣例照抄,像雜草一樣,一不注意就長滿整座花園。
183 個計時器:一個臨時修補怎麼在五週內擴散
雜草長滿花園的速度有多快?她舉了 Cursor 這個 Electron App 的例子。
投影片上的時間線是這樣的:
- 9 月 9 日,agent 用一個
setTimeout(() => release(id), 0)修好畫面閃一下的問題,旁邊附上註解// release later, in case it comes back。投影片上記下的 agent 說法是:「那會是比較大的修改」。 - 10 月 3 日,這個寫法被抄進共用模組。
- 10 月 17 日,程式碼裡已經有 183 個計時器。
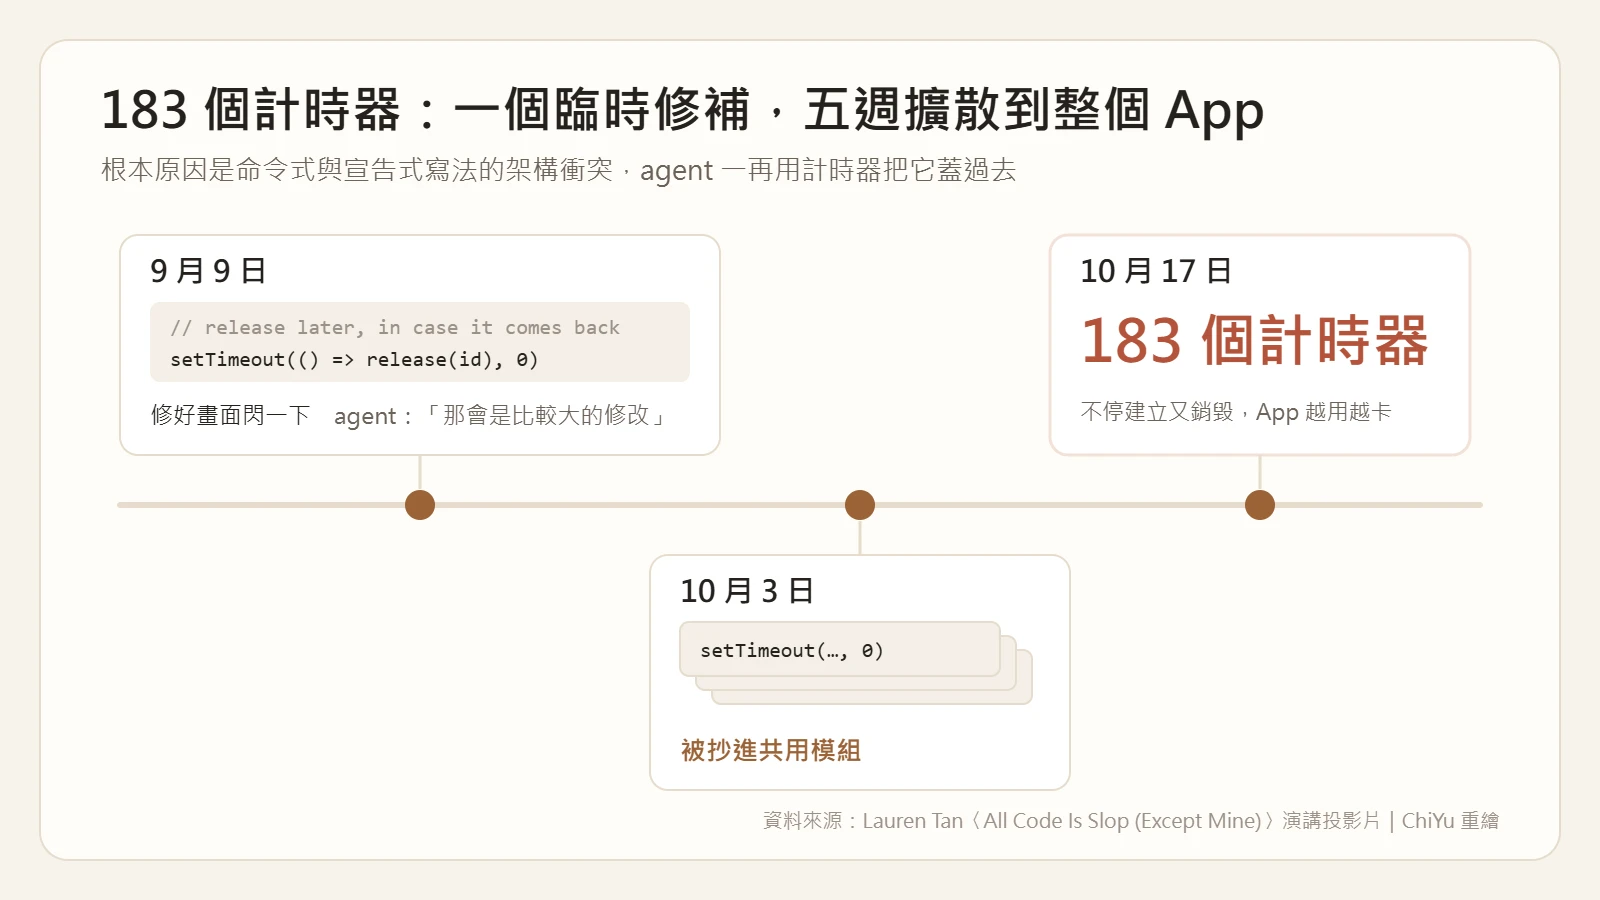
183 個計時器的時間線:9 月 9 日的一個臨時修補,五週後擴散成 183 個
這些計時器不停建立又銷毀,觸發大量垃圾回收,App 越用越卡。根本原因其實是架構衝突:VS Code 的命令式寫法和 React 的宣告式寫法撞在一起,agent 只是一再用計時器把衝突蓋過去。更麻煩的是,agent 會在註解裡替這個臨時修補辯護,下一個 agent 讀到註解,就把它當成合理的做法繼續抄。
Grok Bot 的團隊從這裡學到教訓,做了幾件事:
- 幾乎全面禁用註解:註解數從 7 月 31 日的 65,824 個,降到演講當時的 1,227 個。她的理由是註解容易過時、人類通常不讀,還會變成 agent 替「不做對的事」找藉口的地方。最關鍵的是,註解沒辦法強制執行。
- 改用 lint 規則:錯誤訊息直接告訴 agent 要修根本原因,不要繞過去。
- 禁用需要拿捏分寸的 API:她認為凡是要拿捏分寸才用得好的東西,最後常會變成 slop。React 的
useEffect在產品程式碼裡被禁用,只留在自家框架 Dune 內部使用,整類問題直接消失。 - 用目錄結構傳遞脈絡:頂層直接分成
electron/main與electron/renderer,兩邊互相 import 會被依賴圖分析和 lint 擋下。
接著她給出整場演講的核心原則:每次糾正 agent,就把它變成一條確定性檢查,或用更好的 API、架構把整類問題消滅掉。投影片上的確定性檢查,從 7 月的 7 條,累積到 11 月的 167 條。做夠多次之後,code review 要注意的東西越來越少,最後大部分 PR 可以讓 agent 自己合併。
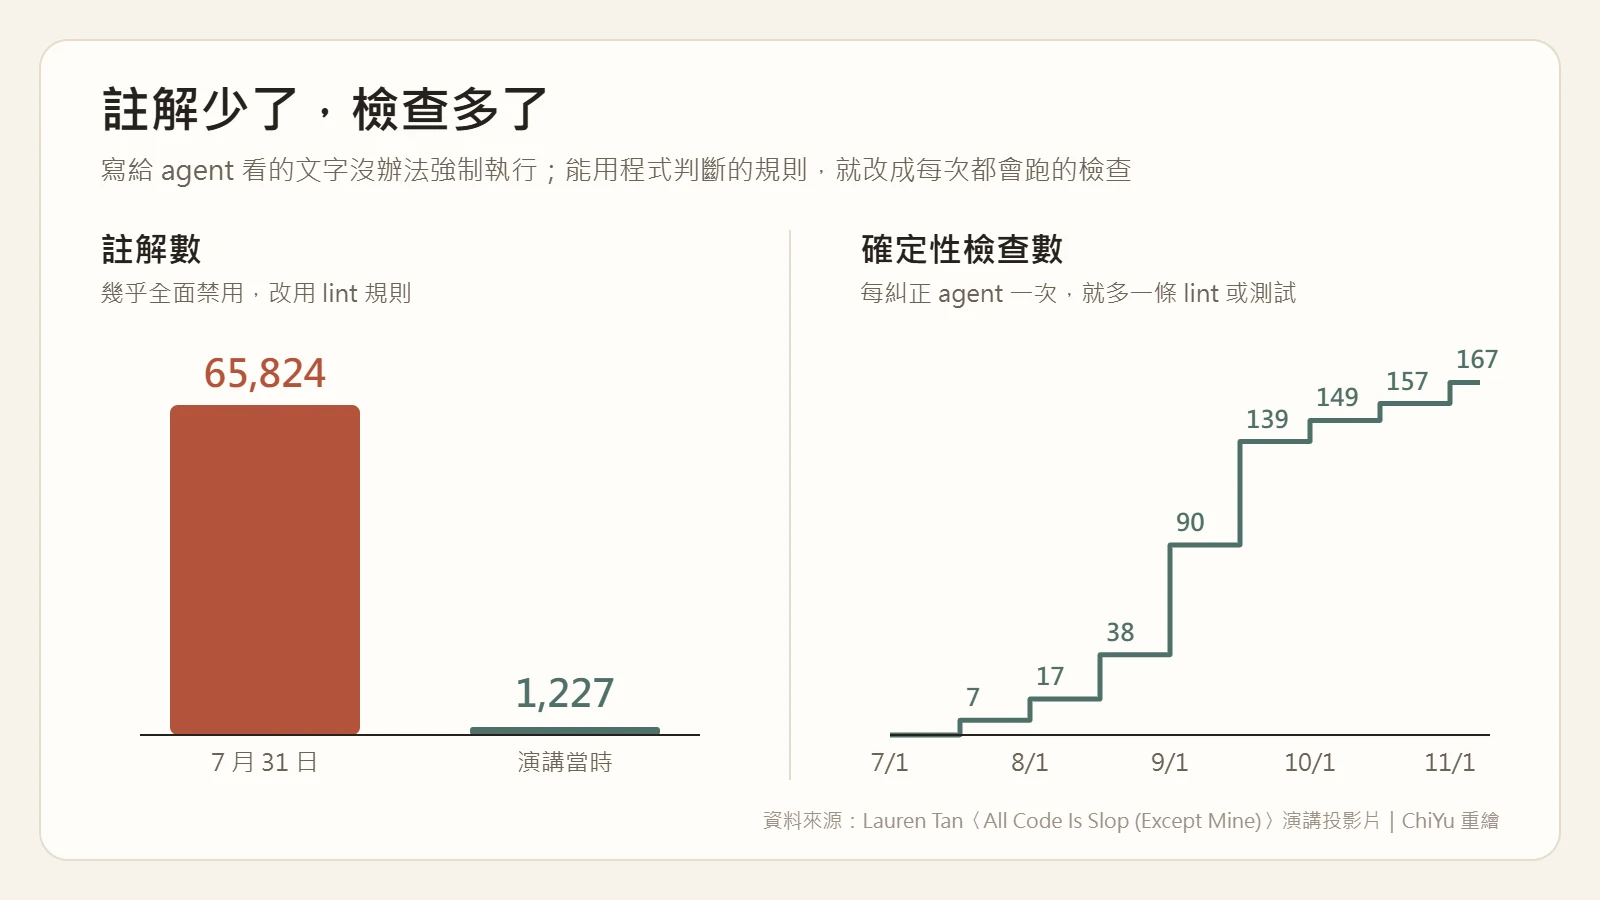
註解從 65,824 個降到 1,227 個,確定性檢查從 7 條累積到 167 條
驗證:Cindy Sridharan 七成的 token 花在驗證
前兩層擋得住寫法,擋不住「寫法沒問題,行為卻錯了」。所以金字塔的第三層是驗證。
Lauren 說,她們的 code review 已經縮成看驗證證據:影片、截圖、圖表,還有形式化驗證的結果。她們用了幾種做法:
- 執行期驗證:讓 agent 自己把 App 跑起來,用 Chrome DevTools Protocol 這類工程師平常用的除錯工具。Skill 裡有一份 feature map,從使用者角度列出 App 的所有功能,你說「左邊側欄那個東西」時,agent 不用猜。她們也把操作寫成自訂 CLI,agent 每次重用,省 token,也能測試。
- 形式化驗證:用 TLA+ 做跨裝置通知流程的模型檢查,用 Lean 證明自製的虛擬化清單捲動時不會閃爍或抖動。她說已經抓到不少 bug,但不是萬靈丹,只是環境裡的另一層。
- UI 的 property-based testing:用 Bombadil 這個函式庫,也抓到幾個 UI bug。
她還引用了 Cindy Sridharan 的兩則貼文。2026 年 5 月,Cindy 抱怨好幾個 AI 產生的 PR 藏著小 bug,合併後花了好幾天手動驗證才修好。半年後她回頭看,說當時缺的就是驗證流程;現在她每天的 token 有七成花在驗證 patch,只有兩到三成花在產生 patch。
Lauren 說她的 token 也大多花在驗證。她特別強調,這些技術沒有一樣是新發明,只是過去太難懂、太難寫、太難維護,成本高到一般團隊用不起;agent 把這個成本大幅壓低,所以她把現在稱為軟體測試與驗證的黃金時代。
這和我在 Uncle Bob 那篇 整理的觀點是同一件事:以前太貴、懶得做的品質工作,有了 agent 之後終於做得起。
成績單:revert 比例減半,退步的數字也留在表上
花了六個月打地基,換到什麼?
- 團隊每月合併的 PR:6 月 809 個,10 月 10,926 個。
- 除了核心團隊,也多了很多對脈絡不熟、順手來改一點的貢獻者;10 月大約有 227 人送過至少一個 PR。
- 大約每天發一個穩定版。
revert 比例(被撤回的 commit 佔比)反而下降,從 6 月的 0.98% 降到 10 月的 0.47%:

Grok Bot 團隊 6 月到 10 月的成績:每月合併的 PR 與 revert 比例
效能那張表的標題是「velocity without compromise」。冷啟動從 2,304 ms 降到 1,395 ms,打字、切換對話也都變快。
不過同一張表上也有變差的項目:閒置記憶體從 488 MiB 增加到 545 MiB,調整視窗大小從 3.0 ms 變成 6.9 ms。這些紅字她沒有拿掉,表格底下還寫著 Electron 有天花板,她正在考慮用 Rust 重寫。
這組數字我會這樣讀:revert 比例只算「被撤回」的 commit,直接往前修掉的小 bug 不會算進去;數字也是團隊自己統計,沒有外部對照組。所以它證明的是「速度變快十幾倍,品質沒有明顯崩壞」,不能直接推成「agent 寫的 code 比人寫的好」。願意把退步的項目留在表上,反而讓整張成績單比較可信。
先別急著蓋軟體工廠:內圈會產出 slop,自動化只會更多
最後一段,Lauren 勸大家先別急著蓋軟體工廠。如果內圈寫程式的流程會產出 slop,把它自動化只會產出更多 slop,還得砸越來越多 token 下去。
她要大家先回到程式碼庫:每次糾正 agent,先用 lint 擋住新的反模式,再把舊的寫法清掉,然後把驗證做扎實。
地基打好之後,外圈長這樣:X 上的回饋、Linear 新 ticket、Slack 訊息、排程、Datadog 或 Sentry 警報,都能觸發一個全團隊共用的 Grok Bot,再交給內圈「agent 寫、agent 驗」。每次發新版,Grok Bot 會自動派 agent 把整個 App 從頭用一遍做 fuzz,找到 bug 就各開一個修正 PR,而且自動合併。她說敢這樣做,是因為程式碼庫夠好,PR 預設就是好的。
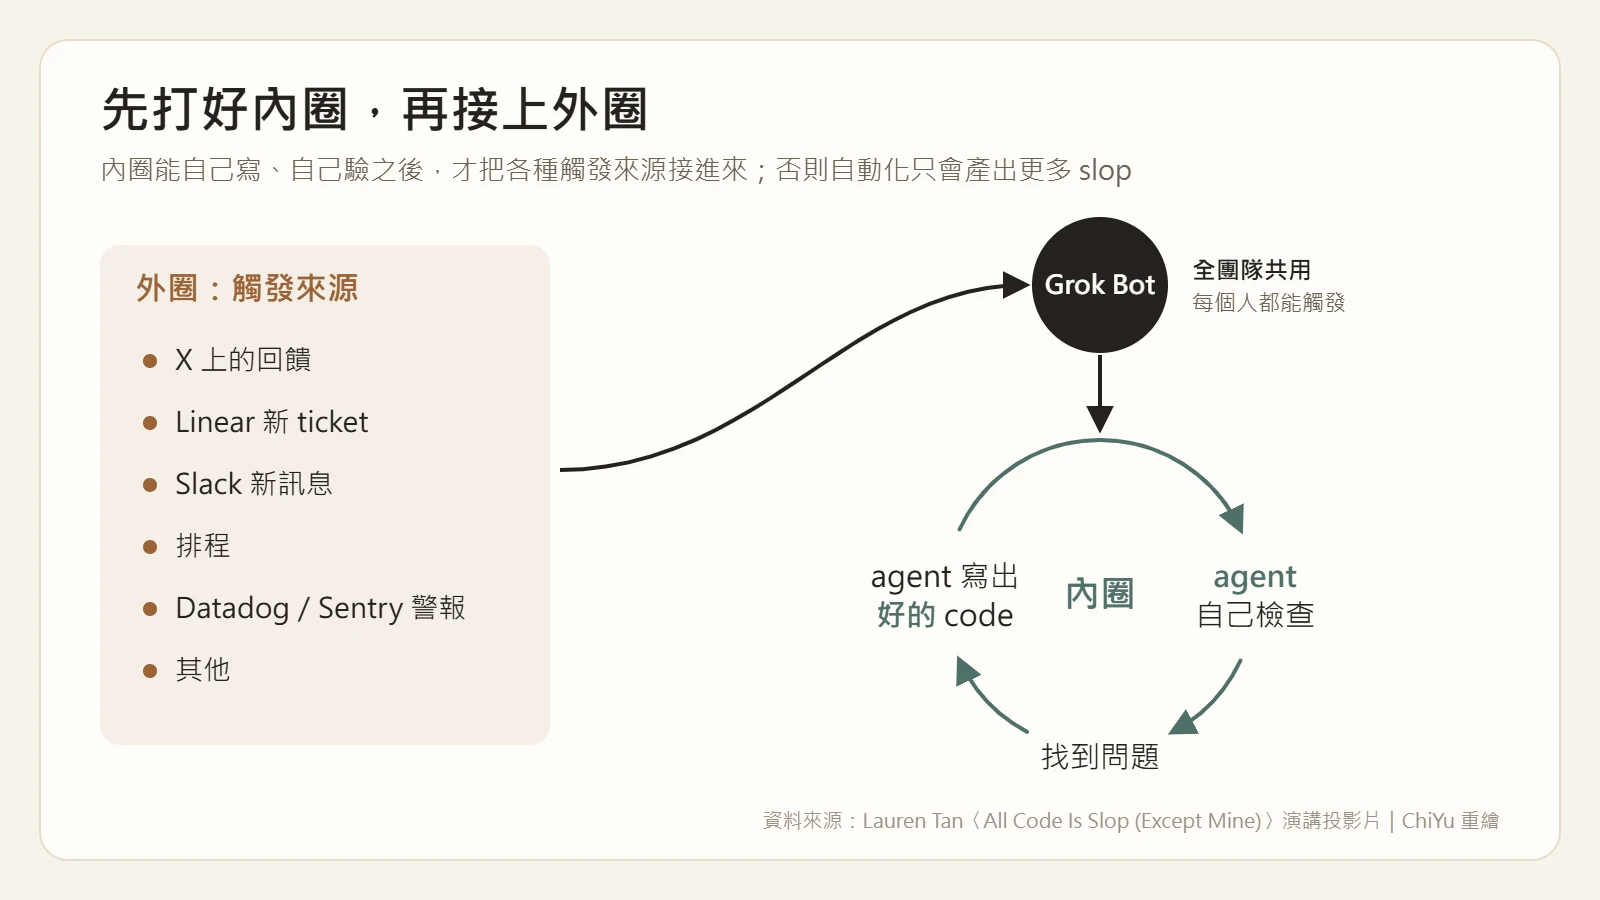
外圈的觸發來源交給全團隊共用的 Grok Bot,再進入 agent 寫、agent 驗的內圈
我現在在用的 Pyloxa:Agent 說做完了不算數
Lauren 的倒金字塔,剛好可以拿來對照我現在在用的 Pyloxa。先說明一下,Pyloxa 是我自己開發的 App,官網在 https://pyloxa.com/ 。
Pyloxa 是一個 Windows 桌面 App,讓 Claude Code 和 Codex 在同一個專案裡分工。把要做的事說一次,由一個當「大腦」的 agent 讀專案、擬計畫;每個工作依你寫的派工規則交給某個 CLI,在自己的 git worktree 和分支上執行。它跑的是你自己登入的官方 CLI,用的是你自己的訂閱或 API key,不轉售也不代理 AI 服務。
對照她的金字塔,Pyloxa 最用力的是第三層驗證。官網講檢查的那一節,標題就叫「Agent 說做完了不算數」。截至 2026 年 11 月 18 日的 v0.2.0,它是這樣做的:
- 驗證命令由你核准,Pyloxa 自己跑:例如
npm run test,可以先在暫時的 worktree 試跑,大腦只能用你核准過的命令。命令在每個工作自己的 worktree 執行,通過才算完成;沒通過,就自動交給 agent 修正一次。 - 核對寫入範圍:計畫會寫明每個工作能改哪些檔案,完成後核對改動是不是都在範圍內。工作改到
.github、.claude、CLAUDE.md這類影響 agent 與自動化的檔案時,一律不自動接受。 - 換一個 agent 來測:完成的工作可以交給另一個 agent 測試,例如 Codex 開發、Claude Code 補測試。測試者只能修改測試檔,Pyloxa 會在成果上重跑你的命令。大腦也一律不驗收自己做的工作。
- 階段 Gate:每個階段結束時,在整合後的版本再跑一次 Gate 命令。通過後可以自動進下一個階段,也可以停下來等你核准。
驗證命令是在 Pyloxa 的「驗證命令」頁核准的。Pyloxa 會依專案內容提出建議,例如 package.json 裡的 lint 和 test script,但不會自動啟用:

Pyloxa 的「驗證命令」頁:依專案內容建議 pnpm run lint 與 pnpm run test,逐一核准或先試跑
前兩項是 Lauren 說的確定性檢查:命令過了就是過了,agent 沒辦法用一段註解把紅燈解釋成綠燈。後兩項是驗證層:換一個 agent 補測試,避免同一個 agent 替自己的成果背書;整合後再跑一次 Gate,抓「每個工作單獨看都對,合起來卻壞掉」的問題。
Gate 沒通過時,畫面會直接列出失敗的命令和輸出,讓你選擇重新驗證,或交給 agent 修正:
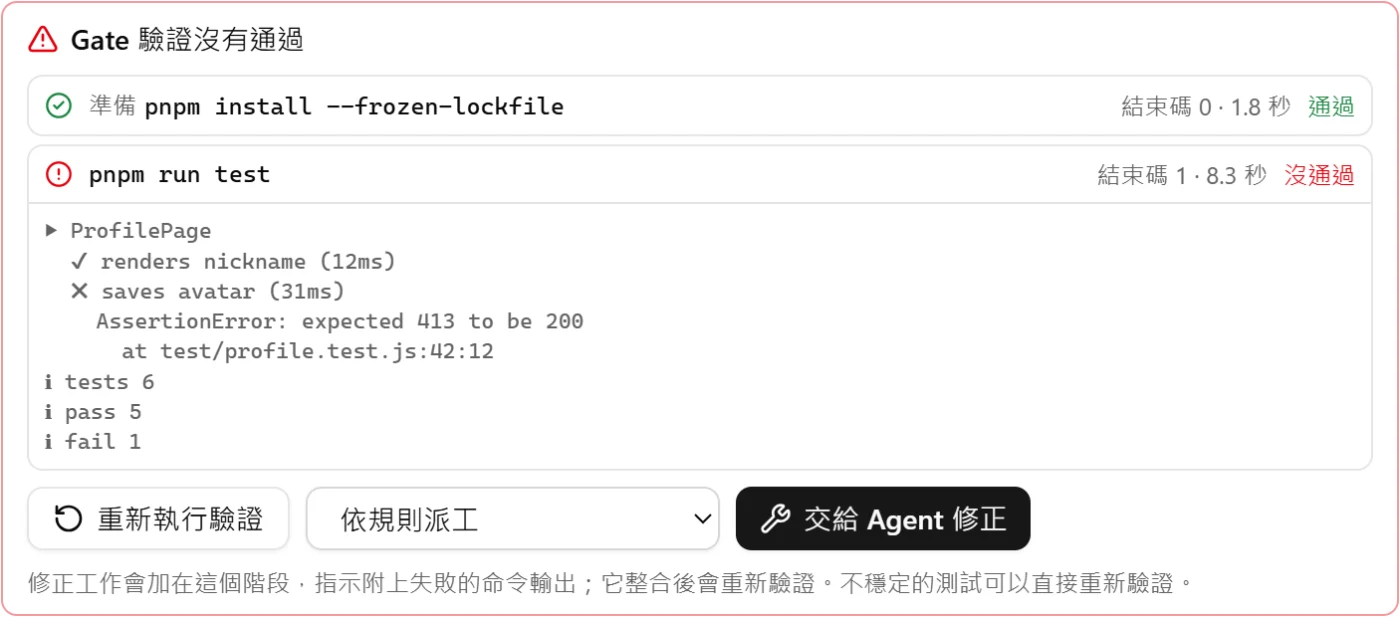
Gate 沒通過:pnpm run test 有一個測試失敗,可以重新驗證或交給 Agent 修正
Lauren 說她們的 code review 已經縮成看驗證證據。Pyloxa 對應的是「驗證報告卡」:PR 說明可以附上每個階段一張表,寫明誰做的、誰交叉測試、Pyloxa 跑了哪些命令、成果怎麼被接受。最後一行預設不加;打開之後,也只有每個成果都通過 Pyloxa 執行的命令、每個 Gate 都通過時,才會寫「Verified with Pyloxa」,否則只寫「Verification record by Pyloxa」。
金字塔的文字層,Pyloxa 也沒有省略。專案的規則、慣例和踩過的坑,記一次就能讓 Claude Code、Codex 都讀到,也能寫進 AGENTS.md 的 Pyloxa 區塊;agent 提議的新記憶,要你接受之後其他 agent 才看得到。照 Lauren 的分法,這一層適合放「一律用 pnpm」這種需要上下文的慣例,能用命令判斷對錯的,還是交給驗證命令。
至於她勸大家先別急著蓋的軟體工廠,Pyloxa 做的是前面提到的內圈:agent 寫,命令和另一個 agent 驗。合併到你的分支、推送和開 PR 都等你按下,推送和部署不會自動發生。
有一點要先講清楚:Pyloxa 只會跑你核准的命令。專案本身如果沒有測試和 lint,能核准的驗證命令也就不多。Lauren 說的程式碼與靜態分析那兩層地基,還是要先在自己的專案裡打好。
下次糾正 AI 前,先問它能不能變成檢查
把 Lauren 的原則畫成流程,大概是這樣:
flowchart TD
    A["又糾正了 agent 一次"] --> B{"能改 API、架構或目錄結構,<br/>讓錯的寫法寫不出來嗎?"}
    B -- 能 --> C["改程式碼本身<br/>例如禁用 useEffect、main 與 renderer 分開"]
    B -- 不能 --> D{"對錯能用程式判斷嗎?"}
    D -- 能 --> E["寫成 lint、測試或發布關卡<br/>錯誤訊息直接說怎麼修"]
    D -- 不能 --> F["寫進 AGENTS.md 或 Skill<br/>留給需要判斷的事"]
文字規則沒有被她丟掉,只是被放回它該在的位置:需要讀懂上下文才能判斷的事。其他能用程式判斷對錯的規則,寫在 AGENTS.md 裡就只是一張便利貼,agent 讀了可能照做,也可能像那個 setTimeout 一樣,在註解裡替自己找個理由。
看完的感想:要駕馭 AI,驗收也要延續下去
看完整場演講,我的整體感想是:大家都越來越往同一個方向走,盡量減少人類介入的痕跡,讓 AI 自主成長。Lauren 的團隊已經讓 agent 自己合併大部分 PR,發版後的 fuzz 和修正也交給 agent 跑完。
這也讓另一個問題更難回答:未來人類的價值,要怎麼衡量?
我的答案是,還是要先抓好自己領域的知識。Lauren 能把 useEffect 禁掉、把 main 與 renderer 分開,是因為她們把開發桌面 App 學到的教訓寫進了框架和 lint 規則;這些規則要寫得出來,得先懂那個領域哪裡容易出事。
要駕馭 AI,而不是讓 AI 駕馭我們。
所以我接下來想調整的是驗收。過去我的驗收,比較多是在判斷單一次任務的成功或失敗;接下來,我會改成看這次驗收的結果,能不能留到下一次再用。驗收不是只有單次,要能延續下去:讓 AI 知道好的結果該保留,壞的要剔除。
回頭看,Lauren 那張從 7 條累積到 167 條的圖,就是一種延續下去的驗收:每一次糾正都留下來,變成下一次的檢查。
回到講題〈All Code Is Slop (Except Mine)〉。聽完整場,「除了我的」那四個字,比較像是在說:是不是 slop,跟誰寫的關係不大,看的是 code 長在什麼樣的環境裡。
延伸閱讀
- All Code Is Slop (Except Mine) — Lauren Tan, SpaceXSI
- SpaceX 主任工程師教你:讓 AI 少寫垃圾 (中文精華,說明欄標示為 AI 製作)
- Lauren Tan 的 pstack 外掛
- Pyloxa 官網 與 工作流程說明
- AI 寫得更快之後,我們該如何相信它?Uncle Bob 談 Agent 時代的軟體基本功
- Day 6|註解與格式都漂亮,程式碼為什麼還是難讀?
- Day 24|Use Case 直接依賴 DbContext,架構測試為什麼還是綠燈?用 Dependency Rule 找出掃描盲點
- Day 26|AI 說測試全綠還不夠:如何固定版本、重跑驗證,留下可查的完成證據?


留言討論
用 GitHub 帳號留言,留言會同步到這個 Blog 的 GitHub Discussions。