本文同步自 2026 iThome 鐵人賽原文 。完整系列可見 iThome 系列頁 。
安安~我是ChiYu~
三十三天前,我手上其實只有三份材料:一本 753 頁、厚度大約五、六公分的《無瑕的程式碼 第二版》,兩則 Uncle Bob 談 Coding Agent 的 X 貼文,以及這段時間大量使用 AI Coding 累積下來的感受。
寫到一半,材料又多了一份。Uncle Bob 後來接受開發者與教育者 Matt Pocock 的長篇訪談,再次談到 AI Agent、Clean Code、測試與軟體基本功。當時系列架構其實已經成形,但內容實在太貼近這次主題,我最後還是回頭調整前面的文章。
前兩個系列從七月開始準備,進入九月前也把稿件如期完成。照理說,第三個系列大可以不要開。
但我最後沒有等到九月底才決定,而是讓第三個系列也在九月一起上場。時間已經很緊了,我心裡還是一直放不下這個題目,甚至覺得它可能比前兩個系列更值得寫。最後就一路從原本規劃的三十篇,寫成了三十三篇。
當時我想回答的問題其實很直接:
AI 已經能快速產生大量 Code,工程師甚至可能不再逐行閱讀所有 Implementation,Clean Code 還重要嗎?
這三十三篇裡,我讓同一個 Work Item API 不斷被 Agent 修改、測試、拆分、重構、故意弄壞,再重新 Review。一路從命名、註解、函式與類別,走到測試、SOLID、元件、並行、架構邊界、團隊合作與估算。
大前天已經正式回答 CLEAN 從哪裡來;前天與昨天則把 Policy 整理成開源 Skill。最後這一篇,我不想再把整套框架重新教一次,而是回到我自己:寫完以後,我實際改變了哪些工作習慣?
真正改變的不是我多記住幾條 Clean Code 規則,而是我現在會怎麼把工作交給 AI、怎麼看它說「完成」,以及哪些事情我不再願意只看一張綠燈就接受。
下面五個結論,就是目前我最想留下的答案。
三十三天的路線:從 Clean Code 的品質判斷,走到 AI 協作的 CLEAN 原則
《無瑕的程式碼 第二版》沒有只停在「函式要短、名稱要清楚」。它從 Code 一路談到 Design、Architecture 與 Craftsmanship,最後回到軟體工程師如何合作、估算、維持生產力、尊重其他程式設計師,以及持續學習。
AI Coding 加快產生 Code 的速度,這四個層次仍然存在。Agent 寫出的函式要被理解,Model 要符合資料與業務角色,元件要守住依賴方向,團隊也要能接手 Prompt、Diff、測試、例外與風險。
這三十三天最後留下五個責任位置:
| 層次 | 在 AI Coding 中負責什麼 |
|---|---|
| Clean Code | 提供可讀、可測試、可改變與可維護的品質判斷。 |
| CLEAN | 規範 User 駕馭 AI Agent 時,必須主動執行與驗收的五項責任。 |
| Repository Policy | 保存特定專案反覆出現的判斷條件、禁止事項與停止點。 |
| Skill | 將跨 Repository 可重複使用的判斷流程、證據格式與 Review 方法包裝起來。 |
| 持續學習 | 當模型、工具、Repository 或風險改變,再次驗證這套工作方式。 |
這條路線不是再多堆一層框架,而是把責任放回正確位置:Clean Code 提供品質根基,CLEAN 管 User 與 Agent 的協作,Policy 與 Skill 幫忙重複執行部分判斷;最後接受什麼風險,仍然沒有人可以替工程師簽名。
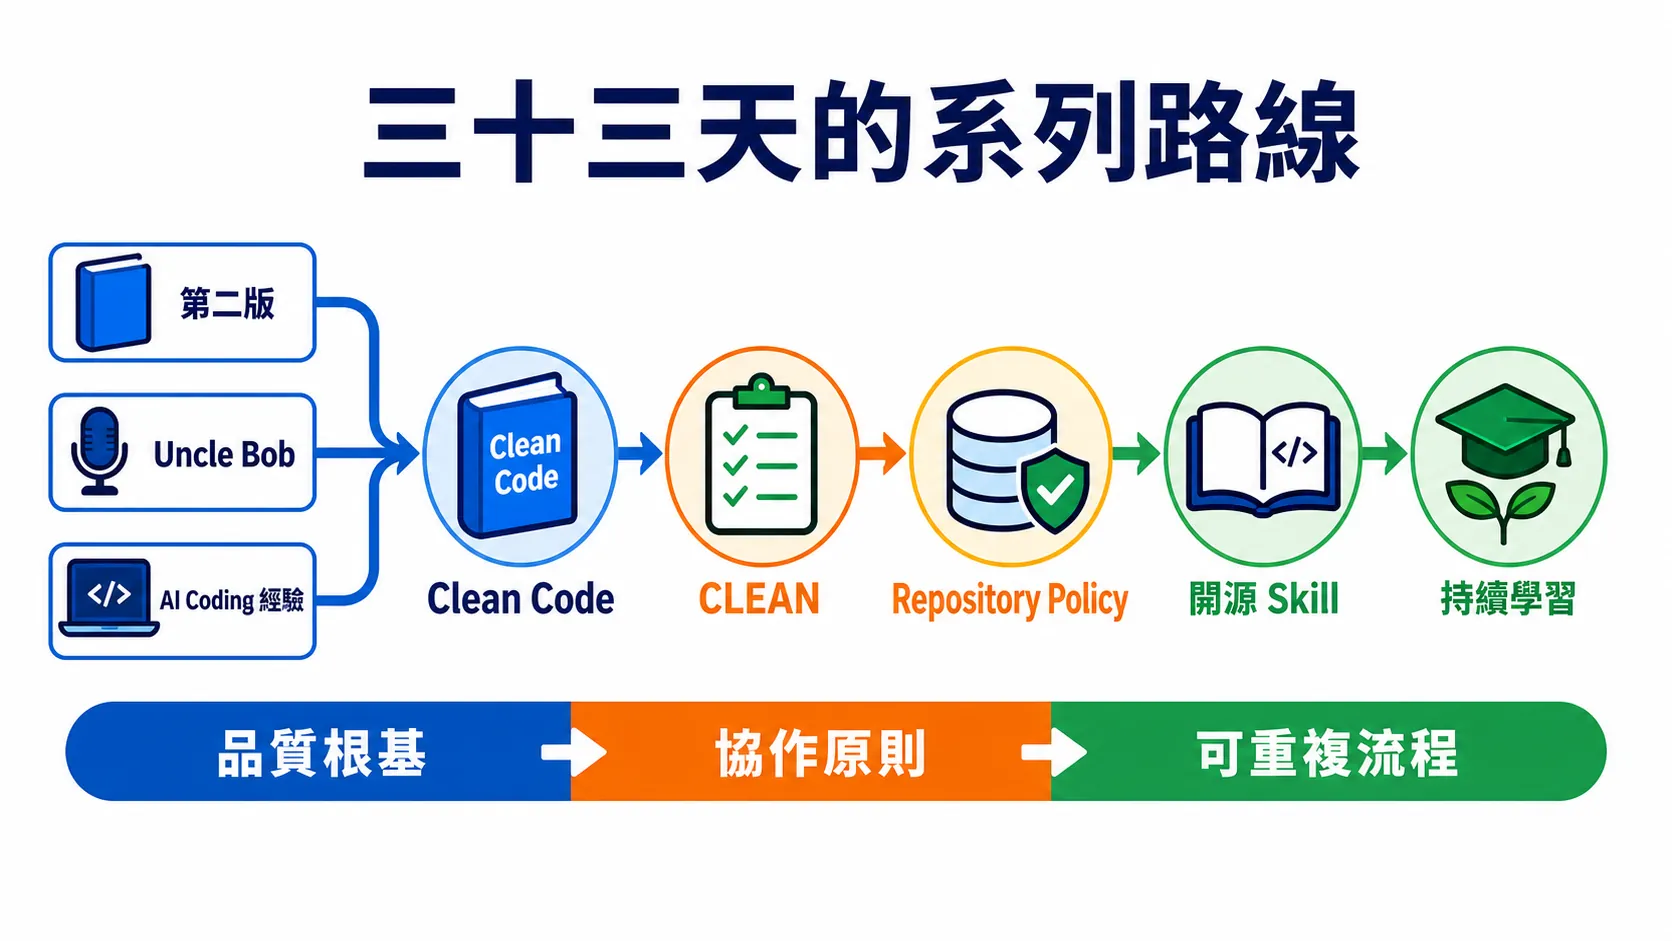
圖:書、Uncle Bob 與實作經驗形成 Clean Code 根基,再延伸為 CLEAN、Repository Policy、開源 Skill 與持續學習。
結論一:AI 產生 Code 很快,完整交付仍包含理解、驗證與返工
這個系列裡,Codex GPT-5.6-SOL-HIGH 確實能在短時間內完成大量修改。可是「第一次產生答案需要多久」,只反映整段交付的一部分。
幾次實驗都出現同樣提醒:
- 模糊地要求「幫我改成 Clean Code」,Agent 會自行決定範圍與設計方向,結果看似整齊,卻不一定符合 Repository 真正需求。
- 功能測試通過後,人工通知重送仍可能繞過既有 Outbox,形成第二條外部副作用路徑。
- Architecture Test 顯示全綠,實際掃描範圍卻可能沒有涵蓋真正的違規位置。
- 測試資料寫錯時,TDD 也會很有紀律地阻擋正確的 Production Code。
共同點是 Agent 很快完成「被交代的答案」,完整交付卻還包含需求理解、邊界確認、失敗處理、獨立驗證與人工裁決。前面省下幾分鐘,後面若花更多時間追查錯誤 Context、修正 Oracle 或清理越界 Diff,團隊沒有真的變快。
這也是我現在第一個改變:我不再只看 Agent 幾分鐘完成。
交付任務前,我會先想清楚完整成本要算到哪裡;Review 時則一起看:
- User 補 Context 花了多少力氣。
- Agent 的 Expected Diff 與 Actual Diff 差多遠。
- Gate 真正保護哪些行為。
- Review 找到多少漏掉的契約。
- 下一個人要重新理解多少東西才能接手。
AI Coding 的生產力應該涵蓋等待、整合、返工與後續維護。產生很多 Code,只是其中一段。
結論二:即使人類少讀一些 Code,Agent 仍需要讀懂名稱、責任與邊界
Clean Code 原本希望讓人更容易閱讀與維護程式碼。進入 AI Coding 之後,閱讀者多了一個 Agent,維護工作也沒有消失。
Agent 要讀名稱,判斷變數與方法代表什麼;讀函式與類別,找出責任應該放在哪裡;讀型別與介面,理解資料角色與依賴方向;讀測試,確認系統已經承諾哪些行為。名稱誤導、責任混雜或邊界模糊時,Agent 一樣會搜尋錯位置、補錯假設,甚至沿著既有壞結構繼續放大問題。
好的命名不保證每次都節省 Token,短函式也不會自動帶來正確設計。不過,意圖清楚的名稱、聚焦責任、穩定契約與可信測試,會讓人與 Agent 有一張比較可靠的系統地圖:
- 名稱說明這裡負責什麼。
- 函式與類別標示責任如何分配。
- 架構邊界指出依賴可以往哪裡走。
- 測試固定不能被偷偷改掉的行為。
所以我現在交付 AI 任務以前,會先多做一件事:檢查它準備模仿的 Repository 範例,是不是我真的想讓下一份 Code 繼續沿用的寫法。
如果現有名稱已說錯意圖、Controller 已繞過 Use Case、測試 Oracle 本身不可信,再好的 Prompt 也只是讓 Agent 更有效率地沿著錯誤線索前進。
人類未來即使減少部分逐行閱讀,這張地圖反而更需要保持可信。
結論三:Clean Code 的品質價值要守住,實作習慣可以重新校準
Uncle Bob 在近期訪談裡,把品質、測試、整潔與可維護性視為需要保留的 Values;人類為了實踐這些價值形成的 Discipline,則可以依 Agent 能力重新檢查。
我後來也把訪談裡談到的函式長度、TDD 節奏、品質關卡、軟體基本功,以及 Values 與 Discipline 的區別,回頭補進前面的文章。這些內容沒有推翻原本架構,反而讓我更清楚哪些 Clean Code 價值應該留下,哪些工作方式可以重新驗證。
以前把函式拆得很小,是為了降低人類一次理解的負擔。AI 擁有更大的 Context Window 後,行數門檻可以放寬;但一個函式若同時處理查詢、狀態、通知、錯誤與回應,下一次變更仍會互相牽動。最後要看的依然是責任、複雜度與修改成本。
TDD 也一樣。高風險業務規則、時間邊界與狀態轉換,很適合先用 Red 說清楚缺口;低風險、已知解法的修改,Agent 先完成一小段 Production Code 再補測試,也可能得到可靠結果。當每個 Checkpoint 都必須立即驗證,而且錯誤修改希望能局部丟棄時,才需要更嚴格的小週期或 TCR。
所以我現在不會用「有沒有照某個形式做」直接判斷 Clean Code。順序會變成:
- 先問真正要保留的品質價值是什麼。
- 再看本次 Repository、風險與 Agent 能力。
- 最後才決定函式要拆多細、測試先寫還是後寫、是否需要額外 Interface 或更強架構邊界。
保留價值,再用證據選擇 Discipline,會比把舊習慣原封不動套給 Agent 更務實。
收尾前的反方 Review:只改四個檔案,仍可能跨越三種系統邊界
在寫下最後兩個結論以前,我又做了一次唯讀校驗。這次沒有要求 Agent 產生新的 Production Code,而是讓兩個相同模型設定的 Session 分工:第一個整理全系列證據與初版 Review 規則,第二個站在反方立場,專門找出可能讓團隊過早降低審查強度的漏洞。
原因很簡單:最後一篇如果只由我整理自己的主張,很容易把三十三天經驗寫成一套過度完整的規則;反方 Reviewer 的工作,就是找出哪些結論已經走得比證據更遠。
它很快抓到一個錯誤分類。我原本把「重新排定到期時間 API」放在中風險,理由是它只修改四個檔案,而且 Build、Tests、Format、Smoke 與架構檢查都通過。重新檢查可觀察影響後,它其實同時跨越三種邊界:
- 新增公開 Route,改變呼叫端能使用的 API Contract。
- 修改
DueAtUtc與狀態,改變持久化資料。 - 更新
ConcurrencyToken,碰到並行控制。
檔案數量少,沒有讓這三種影響消失。我因此把它升到高風險 Review,也修正了「測試全綠」「容易 Revert」「Skill 已執行」可能被誤當成安全保證的問題。
這次校驗沒有證明三條 Review Lane 已適用所有專案。它只讓我更確定一項判斷:Review 強度應依公開契約、資料、權限、交易、並行、外部副作用與架構影響決定,檔案數量與測試數量只能提供線索。
| Review 強度 | 適合的變更 | 人工仍要確認什麼 |
|---|---|---|
| 聚焦抽查 | 不改變公開契約、資料與副作用,而且做法局部、可逆、只有一個明顯方向。 | 完整 Diff、動態使用、影響分析與適用 Gate。 |
| 內部設計 Review | 保留外部行為,只重新分配內部責任或依賴。 | 契約矩陣、主要執行路徑、測試異動與架構方向。 |
| 跨邊界高強度 Review | 涉及公開契約、Migration、權限、交易、並行、外部副作用、部署或不可逆決策。 | 關鍵修改、跨邊界時間線、失敗窗口、復原方式與營運處置。 |
Context 不足、Oracle 可疑、Skill 不適用,或任何指定 Gate 未執行、失敗及無法重現時,都應升級審查或停止交付。完整 Prompt、兩輪輸出與作者裁決保存在 Day 33 Public Evidence 。
結論四:CLEAN 規範 User 如何駕馭 Agent,五項責任共同組成完成條件
CLEAN 是我從 Clean Code 與 AI Coding 實作中整理出的 AI 協作原則。它關心 User 如何提供任務、限制範圍、驗收結果與承擔決策;五項原則彼此並列,實際使用時可以依風險交錯檢查。
到了系列最後,我會用下面五個問題判斷一項 AI 修改能不能被接受:
| CLEAN 原則 | 完成前必須回答的問題 |
|---|---|
| C — Context-Aware Code 情境感知 | Agent 使用了哪些 Repository Facts?哪些仍是 Assumption 或 Unknown? |
| L — Localized Change 局部變更 | 預期 Diff 與實際 Diff 是否一致?有沒有未授權的順手修改? |
| E — Explicit Intent and Boundaries 意圖明確 | 成功、失敗、取消、重送、並行、資料與副作用契約是否已說清楚? |
| A — Auditable by Evidence 實據可審 | Prompt、起始 Commit、完整 Diff、工具輸出、失敗紀錄與人工裁決能否被重新查驗? |
| N — Non-Surprising Behavior 符合預期 | HTTP、資料、Schema、通知與錯誤語意是否仍符合事前定義的 Oracle? |
其中任何一項仍是 Fail 或關鍵 Unknown,都不能拿其他綠燈抵銷。團隊若決定接受例外,也要記錄理由、期限、Owner 與重新驗證條件。
這也是我現在下 Prompt 最大的改變。我不再只寫「幫我把這個功能完成得乾淨一點」,而會盡量先交代:
- 哪些 Repository Facts 已經查證。
- 本次允許與禁止修改什麼。
- 哪些外部行為不能漂移。
- 什麼證據才算完成。
- 哪些未知一出現就必須停下來。
Agent 的自主性沒有因此消失。類別怎麼命名、局部結構怎麼整理、在授權範圍內要用哪個最小實作,仍可以交給它決定。CLEAN 管的是責任與驗收邊界,不是把 Agent 退化成逐行聽命令的工具。
結論五:Policy 與 Skill 可以重複執行規則,最後的工程責任仍然在人身上
前面的文章陸續把命名、註解、函式、Model、測試、SOLID、元件與架構判斷,整理成 Repository Policy 格式;昨天再把能跨專案使用的判斷流程做成公開的 Clean Code AI Collaboration Skill v0.4.0 。
這些載體各自有清楚責任:
| 載體 | 適合負責的內容 |
|---|---|
| Prompt | 本次需求、允許範圍、驗收條件與停止點。 |
AGENTS.md | Repository 專屬規則、架構限制、領域詞彙、建置指令與固定禁止事項。 |
| Tests/Gates | 可執行的行為、契約、架構禁令、Build 與部分副作用檢查。 |
| Skill | 跨 Repository 可重用的判斷流程、方案比較、停止條件與 Review 格式。 |
| 工程師 | 確認 Context 與授權、定義 Oracle、解讀證據、接受或拒絕風險,並決定合併與發布。 |
Skill 可以提醒 Agent 先查情境、限制 Diff、比較方案、執行 Gate 並回報限制。它無法知道沒有被記錄的領域事實,也無法修正錯誤 Oracle,或替團隊接受事故風險。
這三十三天寫到最後,我最確定的反而是這一點:我可以把更多執行工作交出去,但不能把「為什麼可以接受」也一起外包。
《無瑕的程式碼 第二版》最後把焦點放回軟體工藝,剛好補上工具無法承擔的部分:
- 保持高生產力:同時衡量交付速度、返工、Review 成本、技術債與長期修改能力。
- 團隊合作:讓 Prompt、決策、Diff、測試、例外與風險能被下一位工程師接手。
- 誠實且合理地估算:把需求澄清、Context 蒐集、失敗、Review 與驗證時間算進工期。
- 尊重其他程式設計師:不要把難讀、缺乏證據或只有自己能重建的輸出丟給維護者善後。
- 永遠不會停止學習:模型、工具與專案改變後,持續挑戰 Policy、Skill、測試與自己的判斷。
如果 AI 真的替我們省下部分逐行閱讀的注意力,我希望把這些注意力移到契約、架構、風險與團隊知識。只有操作 Agent 的人變快,其他人卻要花更多時間猜測與善後,這樣的速度沒有多少意義。
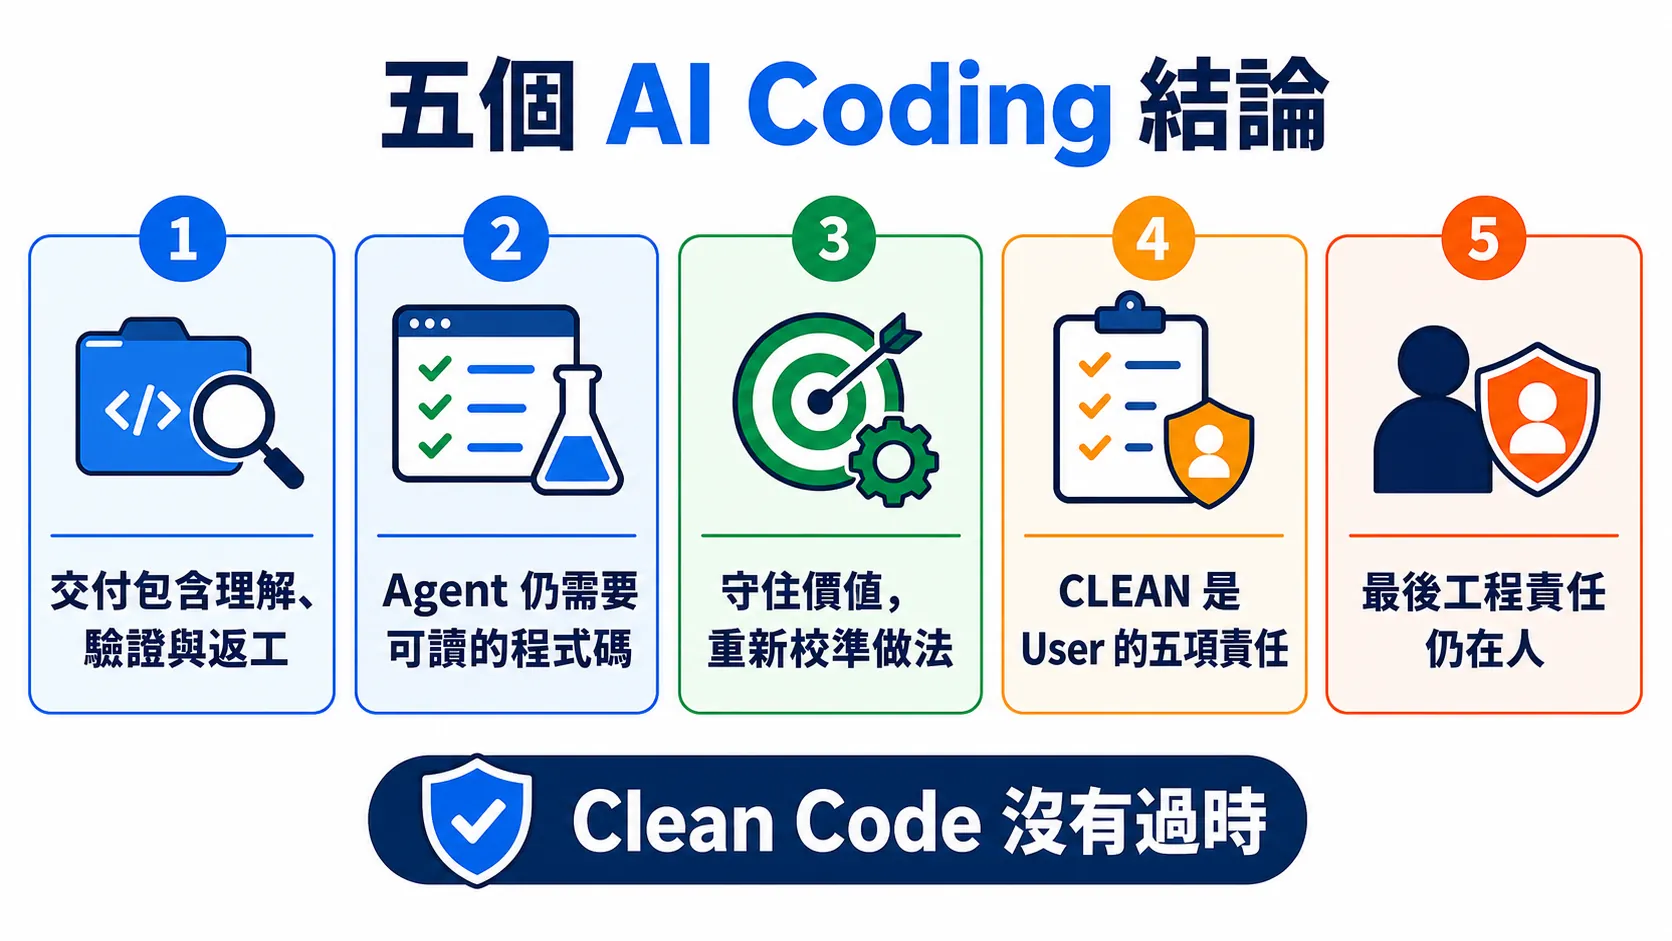
圖:五項結論共同指向同一件事:AI 能加速產生與驗證,品質價值與最後工程責任仍不能外包。
這五個結論仍有適用範圍,不能被寫成所有專案的通則
這個系列的主要實驗集中在同一個 Work Item API、固定的 Codex GPT-5.6-SOL-HIGH、SQLite 與可控制的外部 Provider。它們能揭露模糊 Prompt、錯誤 Oracle、並行時間線、架構掃描與副作用邊界,無法直接代表所有語言、模型、團隊及正式環境。
目前我也沒有足夠證據宣稱 Clean Code 每次都能節省 Token,或 Review Lane 已經能安全降低所有低風險變更的逐行審查比例。公開 Skill v0.4.0 的策略契約評測已完成,但跨語言 Full Run 尚未完成,因此仍需要更多 Repository、技術棧與模型持續驗證。
我願意把這五項寫成目前的工程結論,也會保留修正空間。出現反例時,就回頭更新 Policy、Skill 與文章;這正是〈永遠不會停止學習〉放在全書最後帶給我的提醒。
三十三天後的答案:Clean Code 沒有過時,工程師的責任也沒有消失
有一說一,這個系列的準備量真的比預期大很多。
原本只是想把一本厚到有點誇張的書,和我最近大量使用 AI Coding 的感受放在一起重新讀一次。最後卻一路多了實驗 Repo、幾十組 Session、受控故障、Evidence Packet、Policy、Skill,還因為新的訪談又回頭改了前面的文章。
但我到現在仍然覺得值得。
因為現在再回到 Day 1 那個問題,我的答案已經比「Clean Code 還是很重要」更具體。
AI 可以替我多寫一些 Code,也可以替我跑更多測試、整理 Diff、檢查依賴、產生證據,甚至先替我做一輪反方 Review。這些事情我都很願意繼續交出去。
可是系統真正的 Context 是什麼、這次允許改到哪裡、測試問的是不是正確問題、哪個風險值得接受、什麼時候應該停手,以及最後要不要把這份修改交給下一個人,這些事情我不會因為 Agent 變強就停止負責。
所以三十三天後,我不再把 Clean Code 只看成「讓人類比較好讀的程式碼規範」。它更像是一套讓人與 Agent 都能理解系統、持續修改,又能把責任與證據留住的工程基礎。
CLEAN、Repository Policy 與 Skill,則是我目前操作這套基礎的方法。它們未來一定還會改,甚至可能有些規則幾個月後就被新的模型與工具推翻。這沒有關係。
真正不能丟掉的,是我們願不願意繼續查證、繼續 Review,也願不願意在 AI 很有自信地說「完成」時,還記得最後那個接受按鈕為什麼在自己手上。
謝謝你一路看到這裡。
這個臨時追加、最後一路寫成三十三篇的第三個系列,到今天正式完成了。
參考資料
- Robert C. Martin,《無瑕的程式碼 第二版:敏捷軟體開發技巧守則》,〈無瑕的程式碼〉、〈AI、LLM 以及天知道還有什麼〉、〈軟體的兩種價值〉、〈傷害〉至〈永遠不會停止學習〉。
- Robert C. Martin, 2026-04-14 X 貼文 。
- Robert C. Martin, 2026-07-23 X 貼文與討論串 。
- Robert C. Martin/Matt Pocock, Uncle Bob on Software Fundamentals in the Age of AI:軟體基本功與抽象層演進 ,YouTube,2026-08-19。
- Robert C. Martin/Matt Pocock, Uncle Bob on Software Fundamentals in the Age of AI:新人實作與學徒訓練的討論 ,YouTube,2026-08-19。
- Clean Code AI Collaboration Skill v0.4.0 。
- Day 33 Public Evidence:Evidence Compiler、反方 Review、CLEAN DoD 與作者裁決 。