本文同步自 2026 iThome 鐵人賽原文 。完整系列可見 iThome 系列頁 。
安安~我是ChiYu~
同一段四十多行的 Controller Action,我交給同一個 AI Agent,用兩種整理範圍各跑一次。
兩份結果都通過測試:一份把 Action 壓到十七行,另一份保留三十八行,只抽出單筆逾期處理。若只看行數,十七行贏得很乾脆;但我最後採用的,反而是三十八行的局部版本。
原因不是我突然不在意短函式,而是 Clean Code 真正要判斷的,不只有今天少了幾行,還包括這次拆分是否降低理解成本,又有沒有替下一次修改留下更清楚的位置。
昨天,我先把 CLEAN 五原則整理成 User 駕馭 AI Agent 的協作契約。今天正式進入程式碼層次,我會用 Small、Well Named、Organized、Ordered 檢查兩份重構,再放入一條已知的後續需求,看修改會先落在哪裡。
我要回答的問題很具體:AI 把函式拆小之後,真的比較容易理解與修改了嗎?
原始 Controller Action 同時查詢、改狀態、通知、計數與建立回應
這次仍從同一個系列行為基準開始。實驗對象是 WorkItemsController.ProcessOverdue:它負責找出逾期資料、更新狀態、傳送通知,再回傳處理統計。
[HttpPost("process-overdue")]
[ProducesResponseType<ProcessOverdueResponse>(StatusCodes.Status200OK)]
public async Task<ActionResult<ProcessOverdueResponse>> ProcessOverdue(
    CancellationToken cancellationToken)
{
    var now = timeProvider.GetUtcNow();
    var items = await database.WorkItems
        .Where(item => item.Status != "Completed" && item.DueAtUtc <= now)
        .ToListAsync(cancellationToken);

    var processedCount = 0;
    var notificationAttemptCount = 0;
    var notificationFailureCount = 0;

    foreach (var item in items)
    {
        if (item.Status != "Overdue")
        {
            item.Status = "Overdue";
            processedCount++;
        }

        notificationAttemptCount++;
        var notificationSucceeded = await notificationGateway.SendOverdueAsync(
            item,
            cancellationToken);

        if (!notificationSucceeded)
        {
            notificationFailureCount++;
        }
    }

    await database.SaveChangesAsync(cancellationToken);

    return Ok(new ProcessOverdueResponse(
        processedCount,
        notificationAttemptCount,
        notificationFailureCount));
}
這段 Code 並不難讀。流程從取得時間、查詢資料,一路走到狀態修改、通知、儲存與 Response,而且完全不必跳進其他方法。
問題是,Action 同時負責資料查詢、狀態轉換、外部通知、統計與 HTTP 回應。現在所有東西都放在同一張桌上,伸手就拿得到;下一條規則進來後,也得在同一張桌上重新確認計數、通知與儲存順序。
入口只有一個,不代表改變理由也只有一個。
Small、Well Named、Organized、Ordered 必須一起判斷
《無瑕的程式碼 第二版》的〈基本原則〉把 Small、Well Named、Organized、Ordered 放在一起談,也提醒讀者:這些原則必須放回情境,不能各自變成固定分數。 InformIT 公開的〈基本原則〉全文 可以讀到完整脈絡。
放回今天的 C# 案例,我用四個問題檢查:
- Small:函式是否聚焦在少數決策與同一個改變理由?行數只負責提醒我回頭看。
- Well Named:呼叫端能不能從名稱理解意圖,不必每次跳進實作重新確認?
- Organized:會一起改變的 Code 是否靠近?查詢、決策與副作用有沒有可辨識的責任?
- Ordered:閱讀順序是否接近執行與決策順序,能不能由上而下掌握流程?
這四項會互相牽動。縮短函式可能增加跳轉;補上名稱可能引入一個日後都得維護的新概念。 〈基本原則〉最後的成本討論 提醒我們,每一層新結構都會增加理解負擔。
所以今天不會把十七行直接判成優勝。我真正要看的是:新增的結構,有沒有換來更清楚的責任與更局部的修改位置。
為什麼要比較「廣泛整理」與「只抽出一項責任」
只做一次重構,我只能知道 Agent 交了什麼,無法分辨新增結構是需求所需,還是整理範圍過寬造成的。
因此,兩次實驗固定相同模型、程式起點、API 行為、Database Schema、套件與驗證方式;我只刻意改變 User 授權的整理範圍。
我的假設是:
- 範圍越寬,Agent 越可能追求完整、漂亮且可擴充的流程骨架。
- 範圍越明確,Agent 越可能保留現況,只替已知的改變留下位置。
這組比較觀察的是:在相同 Repository 與模型下,兩種授權範圍會把重構帶往哪裡。模型排名不在比較範圍,Prompt 也不是唯一可能影響輸出的因素。
用下一條已知需求,驗收今天的重構是否容易修改
在 Agent 動手以前,我先凍結一條「只用來評估、不要求實作」的未來規則:
高優先序工作項目逾期兩小時後,需要進入升級處理;其他逾期通知維持既有行為。
這就像挑行李箱時,不只看現在能不能裝下衣服,也會想下一趟多帶一雙鞋時,要從哪裡騰出空間。
我沒有要求 Agent 實作升級流程,也沒有定義升級通道、錯誤語意或 Response 新欄位。評估時,我只看下一次修改會先落在哪裡,以及讀者是否必須同時理解無關的查詢、統計與 HTTP 細節。
廣泛整理:讓 Agent 自己決定應該拆到多深
廣泛整理的完整 Prompt 是:
請以「一次大整理」的方式改善 WorkItemsController.ProcessOverdue,讓程式碼更小、清楚、有組織、有秩序,並降低未來加入「高優先序工作項目逾期兩小時後,需要進入升級處理」規則時的修改成本。這次不要實作該規則。你可以修改完成這次 Production Code 重構所需的檔案,但不得新增產品功能、資料庫 Schema、套件,也不得改變任何既有外部契約與可觀察行為。完成後執行 Repository 規定的驗證,保留實際結果與剩餘風險。
這份 Prompt 固定目標與外部邊界,沒有指定只能抽一個方法,也沒有預先限制可新增的內部型別。我要看的是:當 User 只要求「完整整理」,Agent 會為了縮短主流程增加多少結構。
局部整理:只抽出目前最可能改變的責任
局部整理使用相同目標,再多加一條停止線:
請以「局部整理」的方式改善 WorkItemsController.ProcessOverdue,讓程式碼更小、清楚、有組織、有秩序,並降低未來加入「高優先序工作項目逾期兩小時後,需要進入升級處理」規則時的修改成本。這次不要實作該規則。只處理逾期流程目前最直接的一個責任;新增抽象若只是搬移程式碼、沒有減少閱讀決策或讓新規則得到更清楚的落點,就停止拆分。不得新增產品功能、資料庫 Schema、套件,也不得改變任何既有外部契約與可觀察行為。完成後執行 Repository 規定的驗證,保留實際結果與剩餘風險。
這份 Prompt 讓 Agent 仍可自行命名與實作,但只授權它整理一項改變理由。新增抽象若沒有降低決策成本,也沒有提供更清楚的修改位置,就必須停止。
用 L 限制整理範圍,用 E 說清楚停止條件
昨天已經完整介紹 CLEAN 五原則;今天只帶入最直接影響這次判斷的 L 與 E。
L — Localized Change 局部變更
L 先問:每一行 Diff 是否都服務同一個改變理由?檔案數只能當線索,不能直接證明修改夠局部。
即使兩個版本都只改一個檔案,內部承擔的責任仍可能完全不同。這次我用 L 檢查的是:為了替單筆逾期規則留下位置,究竟需要移動多少不相干的程式碼?
E — Explicit Intent and Boundaries 意圖明確
E 要求我事前交代可修改範圍、禁止事項與停止條件,同時把方法名稱與實作細節留給 Agent。
廣泛整理把內部拆分深度交給 Agent;局部整理則多給了單一責任與停止線。今天要觀察的,就是這項差異最後留下多少結構。
廣泛整理讓主流程縮短,也新增一套逐筆結果資料
廣泛整理最後只修改 WorkItemsController.cs,沒有順手加入 Service、Interface、Repository 或新的架構層。Agent 把 Action 內的查詢、單筆處理、狀態轉換與 Response 組裝分別命名。
它也建立了 OverdueProcessingOutcome。Outcome 在這裡是「單筆處理結果」的資料物件,每一筆都記錄狀態與通知結果,再一起彙整成 Response。整理後的 Action 變成這個樣子:
public async Task<ActionResult<ProcessOverdueResponse>> ProcessOverdue(
    CancellationToken cancellationToken)
{
    var dueWorkItems = await FindDueIncompleteWorkItemsAsync(cancellationToken);
    var outcomes = new List<OverdueProcessingOutcome>(dueWorkItems.Count);

    foreach (var workItem in dueWorkItems)
    {
        outcomes.Add(await ProcessOverdueWorkItemAsync(workItem, cancellationToken));
    }

    await database.SaveChangesAsync(cancellationToken);

    return Ok(CreateProcessOverdueResponse(outcomes));
}
Action 從四十三行縮成十七行,主流程只剩四步:找候選、逐筆處理、儲存、建立回應。
靜態分析顯示,Cognitive Complexity(認知複雜度)從 5 降到 1。這個指標可以指出條件、迴圈與巢狀控制流程造成的閱讀負擔,卻不能單獨判定整體設計一定比較好。
讀者要確認完整行為時,會沿著這條路徑閱讀:
ProcessOverdue
├─ FindDueIncompleteWorkItemsAsync
├─ ProcessOverdueWorkItemAsync
│  ├─ MarkAsOverdueIfNeeded
│  └─ SendOverdueAsync
├─ SaveChangesAsync
└─ CreateProcessOverdueResponse
   └─ OverdueProcessingOutcome
為了換得這條十七行主流程,這個版本新增四個私有方法、一個結果型別、更多閱讀跳轉,以及一份會隨工作項目數量成長的 Outcome 集合。
主流程變短,統計成本也跟著改變
原始版本在迴圈裡直接累加三個計數器,額外記憶體維持 O(1);廣泛版本先保存每筆 Outcome,再掃描集合彙整,額外記憶體改為 O(n)。
這個 Demo 的資料量很小,效能差異未必明顯。真正要問的是:這份逐筆結果之後還有沒有其他用途?若答案是否定的,新增集合與第二次掃描就只是為了換取較短的入口。
局部整理只抽出單筆處理,保留原本的查詢與統計方式
局部版本同樣只修改 WorkItemsController.cs。它沒有整理查詢、統計、儲存與 Response,只把「這一筆逾期資料接下來要做什麼」抽出去:
foreach (var item in items)
{
    var processingResult = await ProcessOverdueItemAsync(
        item,
        cancellationToken);

    if (processingResult.StatusChanged)
    {
        processedCount++;
    }

    notificationAttemptCount++;

    if (!processingResult.NotificationSucceeded)
    {
        notificationFailureCount++;
    }
}
新方法負責需要時把狀態改成 Overdue,接著嘗試通知,再用 Named Tuple 回傳兩個結果。Named Tuple 是把多個具名值暫時組成一組的 C# 結構:
private async Task<(bool StatusChanged, bool NotificationSucceeded)>
    ProcessOverdueItemAsync(
        WorkItem item,
        CancellationToken cancellationToken)
{
    var statusChanged = item.Status != "Overdue";

    if (statusChanged)
    {
        item.Status = "Overdue";
    }

    var notificationSucceeded = await notificationGateway.SendOverdueAsync(
        item,
        cancellationToken);

    return (statusChanged, notificationSucceeded);
}
StatusChanged 與 NotificationSucceeded 讓呼叫端不必只靠位置猜測兩個布林值各自代表什麼。
這份 Action 仍有三十八行,Cognitive Complexity 也維持在 5。只看行數與指標,幾乎看不出改善;查詢、三個計數器、儲存與 Response 也仍留在原位。
它改善的是修改位置。下一條規則關心「單筆逾期工作項目接下來要做什麼」,第一個合理落點就是 ProcessOverdueItemAsync。讀者只需從 Action 跳進這個方法一次,就能看到狀態轉換與通知的先後順序,統計也維持固定的額外記憶體成本。
局部版本沒有宣稱 Controller 已經完成所有責任分離。它只替目前已知的改變切出一個明確位置,做到這裡就停。
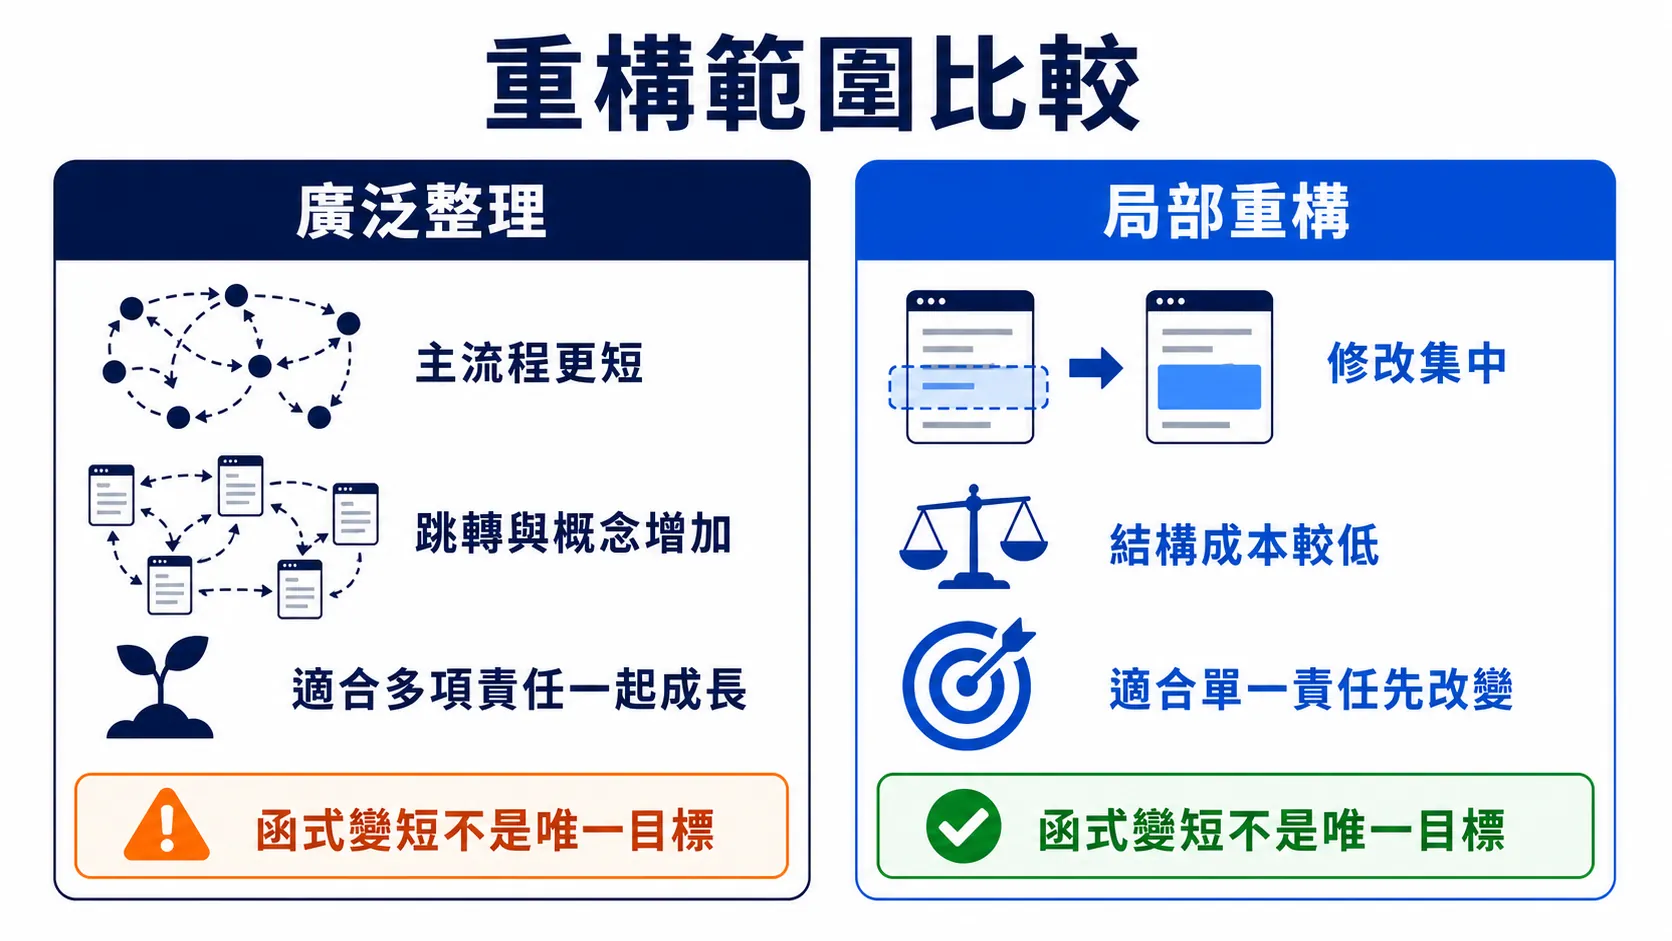
圖:廣泛整理把流程拆成更多方法與結果型別;局部重構只切出已知會改變的單筆處理。
廣泛整理換來短主流程,局部整理保留較低的結構成本
兩份結果的核心差異,來自 User 一開始授權的整理範圍:
| 判斷面向 | 廣泛整理 | 局部整理 |
|---|---|---|
| User 先決定什麼 | 固定目標與外部行為,內部拆分深度交給 Agent | 指定只整理單筆逾期處理,並提供停止線 |
| 主流程閱讀 | 十七行,四個高階步驟清楚 | 三十八行,仍保留查詢、計數與回應細節 |
| 新增概念 | 四個私有方法、一個 Outcome 型別 | 一個私有方法、一個 Named Tuple |
| 找到狀態轉換 | 最深需要跳轉兩次 | 需要跳轉一次 |
| 統計額外記憶體 | 隨工作項目數量成長,為 O(n) | 維持固定,為 O(1) |
| 未來規則落點 | 可分別修改查詢、處理、統計或回應 | 適合先修改單筆狀態與通知規則 |
| 比較適合的情境 | 多項責任已確定會分別成長 | 目前只確認單筆處理會改變 |
這張表不能用來加總分數。原始版本完全不必跳轉,責任仍然混在一起;廣泛版本的 Action 最短,結構成本也最高;局部版本沒有降低 Complexity,卻替下一條規則留下第一個合理落點。
如果未來確認查詢資格、通知種類、錯誤語意與 Response 都會分別演進,廣泛版本就可能更划算。需求範圍一變,適合的整理深度也會跟著變。
我的停止線很簡單:新增抽象必須替已知決策命名,或讓一種變更不必穿過無關責任。只是在更多方法之間搬動原有 Code,我就先停在這裡。
測試確認既有行為沒有漂移,無法替我們決定結構好壞
兩份版本都通過相同的 Restore、Release Build、既有測試、格式檢查、套件弱點檢查與 HTTP Smoke Test。
我也執行 git diff --check,確認 Diff 沒有留下空白字元等基本格式問題。HTTP Smoke Test 則保留系列行為基準的既有結果:第一次執行處理兩筆資料,並嘗試通知兩次;第二次執行不再變更狀態,仍會再次通知兩次。
這次只比較結構,不能順手修掉重複通知,否則功能修改與重構效果會混在一起。
這些驗證能支持「目前已寫進測試的行為沒有漂移」,無法回答哪一種結構比較容易維護。最後仍要回到責任邊界、下一次修改位置與新增成本。
目前只確定單筆處理會改變,因此先採用局部整理
這次我採用局部整理。現階段唯一明確的變更壓力,是單筆逾期後的狀態與通知規則;局部版本用較少的新概念,替這項改變留下足夠清楚的位置。程式碼長度與 Complexity 分數,都不是這次的決定依據。
廣泛整理並沒有被判定為錯誤。如果後續確認查詢條件、通知形式、失敗語意與回應內容都會分別成長,我會重新考慮它的流程骨架。Clean Code 的判斷必須回到情境,不能把某一種拆法永遠寫成標準答案。
這裡的「採用」是本文對兩種結構的判斷,不代表把候選合併回 series-v2。兩份候選都保留為實驗結果,後續文章仍從相同系列行為基準開始,避免今天的選擇改變明天的起點。

圖:只有單筆處理承受明確變更壓力時,先停在局部版本;查詢、通知與回應各自成長後,才升級為廣泛整理。
把今天的重構判準寫成 Refactoring Scope Policy
今天是這個系列第一次把實驗得到的判準,整理成可以放進 AGENTS.md 的 Repository Policy。這份 Policy 是兩份候選完成並通過驗證後才整理出的結果,沒有參與前面的生成或驗收;後續 Agent 才會在 Repository Instruction 中讀到它。
它不規定每個函式只能有幾行,而是告訴 Agent:什麼情況值得繼續拆分、什麼情況適合局部整理,以及什麼時候應該停止增加抽象。
## Refactoring Scope Policy

- 新增抽象必須對應已知的決策,或隔離明確的變更來源。
- 函式變短不是獨立目標;仍要比較閱讀跳轉、新增概念與資料搬運成本。
- 只有單一處理流程出現明確變更壓力時,優先採用局部重構。
- 查詢、通知、錯誤處理與回應建立開始獨立成長時,才考慮較廣泛的結構調整。
- 重構若只把相同程式碼搬到更多方法,沒有提升意圖與邊界的清晰度,就停止拆分。
目前先用 AGENTS.md 示範,讓 Repository 特有的責任與停止條件能跟著程式碼版本化。等這套判斷在更多情境中穩定,而且需要跨專案重複使用時,再把通用流程抽成 Skill。
AI 可以快速拆分函式,User 要用變更壓力決定保留哪一份
回到開頭的問題:AI 把函式拆小之後,真的比較容易理解與修改了嗎?
答案是:只有拆分對準真實的變更壓力時,才會更容易理解與修改。 Small、Well Named、Organized、Ordered 必須一起判斷;主流程變短,不能抵銷多餘抽象帶來的閱讀成本。
L — Localized Change 局部變更 讓我檢查修改是否集中在單一責任;E — Explicit Intent and Boundaries 意圖明確 則迫使我事前說清楚授權範圍與停止條件。這兩項原則沒有替我選出固定答案,而是讓兩份候選的結構成本能被攤開比較。
今天的局部版本替單筆逾期處理留下一個位置,問題卻還沒結束。ProcessOverdueItemAsync 看起來很完整,但它真的說清楚「狀態轉換後一定會嘗試通知」嗎?processingResult 又是不是太像一個什麼都能裝的名稱?
明天,我會繼續處理最常被低估的一環:命名。當大量程式碼由 AI 產生時,好的名稱究竟只是方便人類閱讀,還是也會影響 Agent 理解 Repository 的成本?
實驗重現資訊
主文只保留實驗設計與判斷,完整 Prompt、原始輸出、工具過程與人工 Review 都保存在公開 API Demo。
下表用 Commit SHA 固定版本快照,再用 Annotated Tag 提供可閱讀的名稱與說明。
| 角色 | Commit | Annotated Tag |
|---|---|---|
| 系列行為基準 | cdcd870635128f13d7a3fe0813768ce91ce8b46e | series-behavior-baseline-v1 |
| 廣泛整理 | 37939df072321d180559bf237fe4710ca9e80c16 | day-04-sol-high-broad-run-01 |
| 局部整理 | b7186425915b30aaa48cd81f60ecc1170a212082 | day-04-sol-high-localized-run-01、day-04-first-principles |
讀者可以循這些座標直接核對原始結果,再與本文的整理與判斷互相比較。
兩份候選都使用 Codex GPT-5.6-SOL-HIGH,並分別放在獨立的 Git Worktree 與 Codex Session 執行。Worktree 隔離檔案修改,Session 隔離對話脈絡,避免前一輪結果影響下一輪。
如果想從共同起點閱讀程式碼,可以執行:
git fetch origin --tags
git switch --detach series-behavior-baseline-v1
git rev-parse HEAD
detached HEAD 代表 HEAD 暫時直接指向特定 Commit,而不是停在一般 Branch。這組指令只會讓目前的工作目錄切到實驗基準,不會改寫原本的 Branch 指標;最後一行應顯示:
cdcd870635128f13d7a3fe0813768ce91ce8b46e
參考資料
- Robert C. Martin, First Principles: Everything Small, Well Named, Organized, and Ordered ,Clean Code: A Handbook of Agile Software Craftsmanship, Second Edition,對應〈基本原則〉。
- Robert C. Martin, A More Significant Example ,〈基本原則〉中的結構與成長案例。
- Robert C. Martin, A Final Thought ,〈基本原則〉中的結構成本與認知負擔說明。
series-behavior-baseline-v1,本次兩份候選的共同起點。